知识库、RAG 与存储
本文档基于 Aivory v2.4.7 编写。相关界面:“能力与集成 → 文档”(RAG 与嵌入配置)、“系统 → 存储与上传”(对象存储与上传策略)、用户侧知识库位于前台 /kb。
知识库让模型在回答前检索受限范围内的文档片段。可靠的 RAG 不是“上传文件”一个动作:它依赖可用的嵌入模型、一致的向量维度、成功的解析与索引,以及对用户和工作区的访问控制。
工作流与验收点
上传文件 → 校验类型/大小并保存原始对象 → 解析(文本/表格/OCR)
→ 切块 → 嵌入模型生成向量 → 写入向量后端
→ 提问时只在有权限的范围内检索 → 相关片段注入上下文
文档入库后经历 pending → parsing → embedding → ready / failed 状态流转;异步队列处理期间,输入框会阻止把未就绪文档发出去。等到状态为已完成,再用文件中可精确验证的一句话做检索测试。失败时保留原文件、查看任务错误与应用日志,不要反复上传同一文件来掩盖根因。
入库状态与异步队列
| 状态 | 含义 | 管理员动作 |
|---|---|---|
| pending | 已入库排队,等待 worker 领取 | 正常等待 |
| parsing | 正在提取文本/表格/调用 OCR | 大文件扫描耗时属正常 |
| embedding | 正在切块并生成向量 | 观察是否长时间无心跳 |
| ready | 可检索 | 做一句话检索验收 |
| failed | 某一阶段失败 | 查看任务错误信息与日志,修复后重新入库原文件 |
完整版 ingest 走 Redis 队列(asynq),分 rag(慢车道:OCR/复杂文档)与 rag-fast(纯文本)两条泳道;个人版使用进程内队列,行为一致但吞吐受单进程限制。心跳-恢复循环会回收“半途而废”的文档重新排队,单文档管线有超时上限,因此反复 failed 的超大扫描件应先在外部拆分,而不是无限重试。
支持的格式与解析路径
| 输入 | 解析方式 | 备注 |
|---|---|---|
| txt / md / 源码 / csv / json / yaml 等 | 本地直接读取 | 行数小的源码/文本按“全文注入上限(行)”整篇进上下文 |
| 带文字层 PDF、docx / pptx / xlsx 等 Office | 本地结构化解析 | 标题面包屑参与切块 |
| 扫描 PDF / 图片型文档 | 需要 MinerU OCR | 依赖对象存储预签名 URL,见下文 |
| 图片(png/jpg/gif/webp/bmp…) | 作为多模态附件;需要文字化时走 OCR | 常用栅格格式不受扩展名白名单限制 |
嵌入模型与维度
- 在“AI 与模型 → 模型”添加一个类型为 embedding 的模型(关联支持
/v1/embeddings的渠道,填写真实request_id与向量维度)。 - 进入“能力与集成 → 文档”,在“嵌入模型”区块选择它并保存。
| 字段 | 说明 | 示例 | 默认 |
|---|---|---|---|
| 嵌入模型 | 知识库与文档向量化模型;只能从 kind=embedding 的模型中选择 | text-embedding-3-small | 未配置 |
为避免旧切块与向量库失配,嵌入模型保存后不能更换。页面上的锁定提示是有意设计:确需更换(改供应商、改维度)时,先规划受影响知识库的向量重建,且不要删除唯一的原始文件——向量可以重建,原始文档和元数据丢失后通常无法准确恢复。若所选模型被删除,页面会显示“悬空”警告,需要选择新模型并保存、再重建全部知识库。
部署级回退:环境变量 EMBEDDING_BASE_URL / EMBEDDING_API_KEY / EMBEDDING_MODEL / EMBEDDING_DIM(默认 text-embedding-3-small / 1536)在后台未选择时生效。全部未配置时系统使用内置的本地 hash 嵌入器兜底——256 维、开发级质量,适合试用,不应作为语义检索的长期基线。
最重要的约束是维度一致:EMBEDDING_DIM、模型记录的“向量维度”与模型真实输出必须相同。Qdrant 按维度分集合(aivory_c<dim>),不兼容的向量天然被隔离,但表现为“检索不到结果”。
向量后端:个人版与完整版
- 个人版(SQLite 内嵌向量)
- 完整版(Qdrant)
VECTOR_BACKEND=sqlite(官方个人版固定值),向量写入aivory.db的vector_points表,做精确余弦检索。- 数据库、上传、产物、备份都在同一个
DATA_DIR;单实例,不能放网络文件系统。 - 不需要也不应该为了 RAG 额外部署 Qdrant。
VECTOR_BACKEND=auto:设置了QDRANT_URL即启用 Qdrant;官方完整版 compose 已内置qdrant服务(仅内部网络,不发布端口)。- 不要公开 Qdrant 端口或让应用连接不受控实例;集合按维度自动隔离。
VECTOR_BACKEND属于部署级拓扑配置,无效组合会直接拒绝启动。改拓扑前先读环境变量。
无论哪种后端,60 张表的结构相同:完整版也会创建 vector_points 表但保持为空,使逻辑备份与迁移工具跨引擎一致。域绑定和 Passkey 凭据也是同一关系库中的行,会随常规备份一起保存。
检索与注入参数
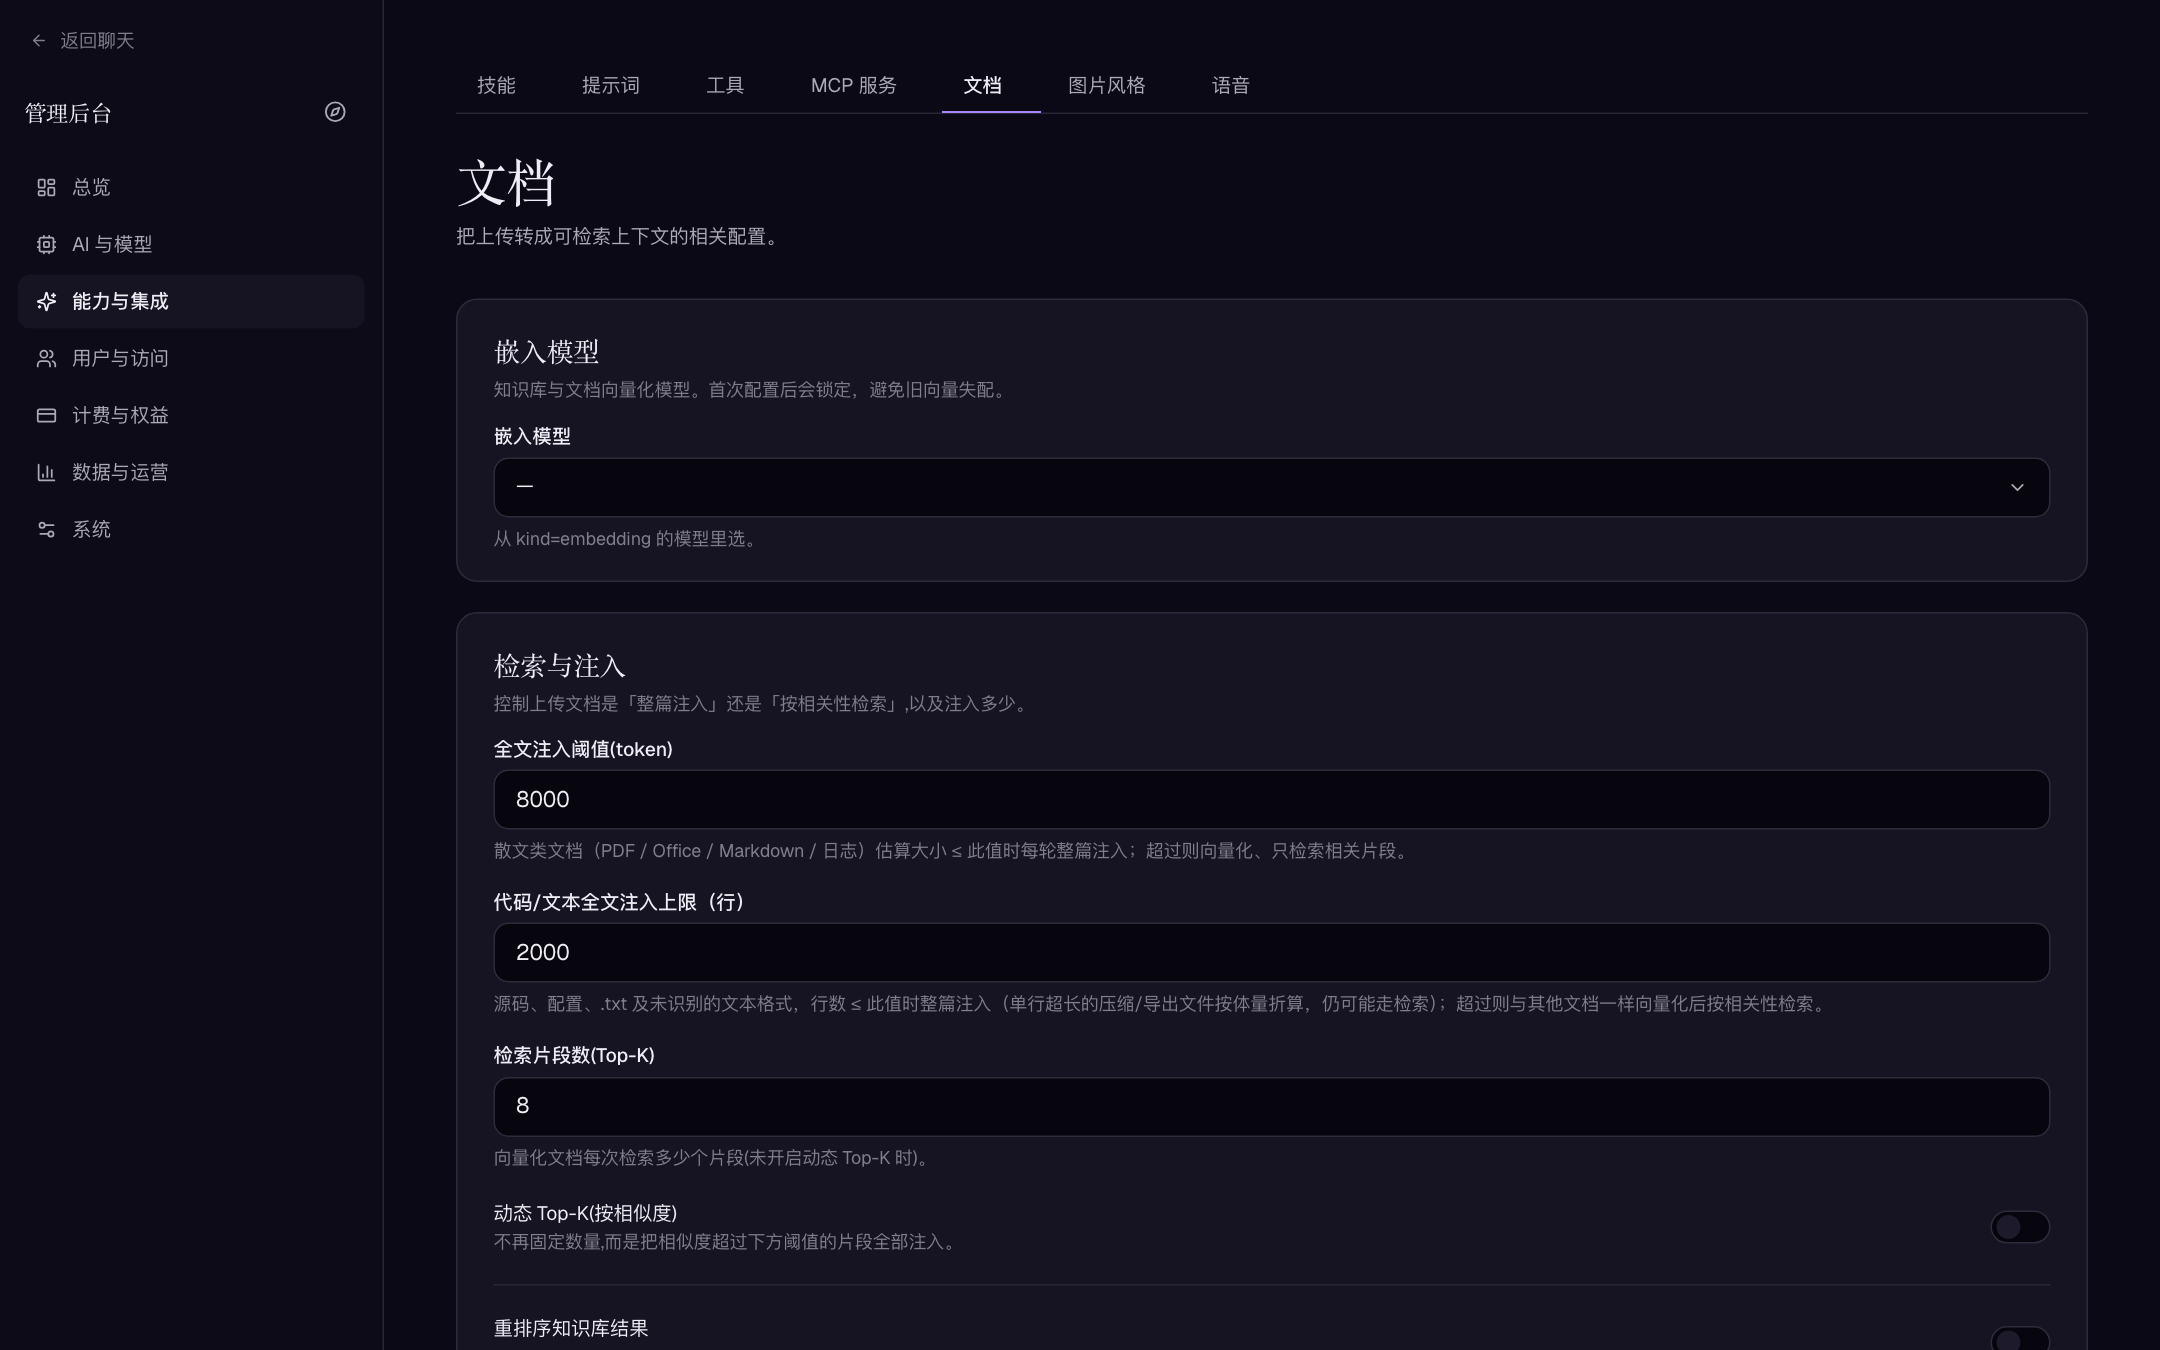
“能力与集成 → 文档”的“检索与注入”区块控制上传文档是“整篇注入”还是“按相关性检索”:
| 字段 | 说明 | 默认 |
|---|---|---|
| 全文注入阈值(token) | 散文类文档(PDF/Office/Markdown/日志)估算 ≤ 此值时每轮整篇注入;超过则向量化后检索片段 | 8000 |
| 代码/文本全文注入上限(行) | 源码、配置、.txt 等行数 ≤ 此值时整篇注入,超过则走检索 | 内置值 |
| 检索片段数(Top-K) | 向量化文档每次检索的片段数(未开动态 Top-K 时) | 8 |
| 动态 Top-K(按相似度) | 不固定数量,注入相似度达到阈值的片段 | 关 |
| 相似度阈值(0–1) | 余弦相似度下限 | 0.5 |
| 重排序知识库结果 | 仅对话附加知识库时启用独立 OpenAI 兼容 rerank 服务;失败自动回退原检索顺序 | 关 |
重排序三个字段:Base URL 必须填以 /v1 结尾的完整地址(后端追加 /rerank,不经过模型渠道)、API Key(作为 Bearer,服务无鉴权可留空)、模型名称。
检索内核行为(AIVORY_* 环境变量,见环境变量进阶):稠密向量 + 关键词双路各取 top-30,按倒数排名融合(k=60);在线检索预算 30 秒,超时会继续对话但不带证据(fail-open);切块按结构感知:子块目标约 2000 字符、父块约 4800、重叠 250。
检索质量调优速查
| 症状 | 优先调整 |
|---|---|
| 明明文档里有答案却检索不到 | 降低相似度阈值或提高 Top-K,或开启动态 Top-K;确认文档状态为 ready |
| 命中一堆无关片段、回答被污染 | 提高相似度阈值、降低 Top-K,或开启重排序 |
| 小文档回答断章取义 | 降低“全文注入阈值”,让该体量文档整篇注入 |
| 换 embedding 模型后全部失效 | 维度或模型不一致:核对锁定模型、维度与重建结果 |
| 长文档偶发“无引用直答” | 检索 30 秒预算超时 fail-open:检查 embedding 服务延迟与网络 |
| 精确型号/编号查不到 | 依赖关键词腿:确认文档未被当作纯向量处理,或适当提高 Top-K |
文档解析与 OCR(MinerU)
- born-digital 文件(文本、带文字层的 PDF、Office、图片格式中的文字)走本地解析链路。
- 扫描件、图片型 PDF 与复杂排版需要 MinerU 云端解析。配置入口有两处:环境变量
MINERU_API_URL/MINERU_API_KEY(启动默认)或“能力与集成 → 文档”页的 MinerU 区块(MinerU 接口地址、API Token,云端默认https://mineru.net)。
非纯文本上传要经 S3/OSS 交给 MinerU:后端直接上传并生成预签名 URL 供 MinerU 拉取。因此启用 MinerU 前必须在“存储与上传”配置完整的 S3 或阿里云 OSS,否则页面会拒绝保存(“MinerU 需要完整的 S3 或阿里云 OSS 配置”)。本地存储的单机部署无法使用 MinerU 路径。
解析失败排查顺序:
- 文件未损坏、未超上传限制、非加密 PDF。
- 解析服务的网络、鉴权、额度与超时。
- 对象存储地址对解析服务可达(预签名 URL 可下载)。
- 查看文档任务状态、应用日志与服务商返回,确定失败发生在解析、嵌入还是向量写入阶段。
不要为让 OCR 成功而把私有桶、内网文件服务器或数据库开放到公网。
存储与上传策略
“系统 → 存储与上传”管理对象存放、上传限制与归档保留(详细字段见系统、备份与运营)。与 RAG 直接相关的边界:
| 项 | 规则 |
|---|---|
| 服务器硬上限 | MAX_UPLOAD_BYTES,默认 50 MiB;页面内任何“图片/文件大小上限”不能超过它 |
| 图片上限 | 后台“图片大小上限(MB)”,默认 5 MB |
| 非图片文件上限 | 后台“文件大小上限(MB)”,0 = 沿用服务器上限 |
| 类型白名单 | 后台按 upload_allowed_extensions 配置;留空使用安全默认集(Office/PDF/文本/图片/常见源码),可执行文件、宏文档、压缩包与 .html/.svg 被有意排除;按最后一个扩展名判定(evil.pdf.exe 按 exe 处理);常用图片格式始终允许 |
| 反向代理 | 代理侧请求体上限必须 ≥ 应用上限,否则表现为上传 413/连接中断 |
提高限制前同步评估:磁盘/对象存储成本、解析内存、备份体积。
权限、引用与分享
- 知识库不是全局公开搜索:检索只覆盖用户有权访问的个人库、项目库、工作空间库与显式分享的库(只读或可上传两档)。
- 用户侧创建流程:前台“知识库”新建 → 选择嵌入维度一致的库 → 上传文件 → 等待索引完成 → 在对话或项目中附加。管理员可在“数据与运营 → 内容资源”查看全部用户的知识库、项目与生成图片,在“文件”页排查、预览或删除(删除会同时清除数据库记录、向量索引与磁盘文件)。
- 引用与分享:带引用的回答被公开分享时,引用片段、附件预览与工具产物会进入只读快照。分享前检查是否包含不该公开的内容;用户删除、工作区移除或权限变更后,验证旧分享链接与旧知识库不再暴露内容。
- 项目级自动化:项目可以绑定一个知识库并开启“自动加入上传”,用户上传即入库、对话默认在该范围内检索;对话级的
rag_mode为 auto 时由文件路由模型决定跳过/检索/全文。管理员解释“为什么这个库没被用到”时,先看这两层开关,再看阈值。
端到端验收清单
对知识库能力建立信心前,按此顺序做一次完整验收:
- 管理员侧确认嵌入模型已配置,且记录的维度与模型真实输出一致(“能力与集成 → 文档”)。
- 前台“知识库”新建一个库,上传一个包含独特字符串的小文本文件。
- 等待状态流转到已完成;索引未完成前输入框阻止发送,属正常行为。
- 新建对话附加该库,用文件里的原句提问:回答应带引用,且引用指向正确的文件与片段。
- 换第二个账号提同样的问题:不应检索到第一个账号库里的内容——越权可见是配置错误,不是模型幻觉。
- 表格文档与扫描样张分别测试:表格按结构化切块命中(切块类型含 text/parent/table/image_caption);扫描件需要对象存储与 MinerU 两条链路都就绪。
容量、成本与常见问题
| 维度 | 事实 |
|---|---|
| 单文档体量 | 管线有单文档超时(约 70–75 分钟量级),巨型扫描件先在外部拆分 |
| 并发 | 完整版两条泳道各 4 并发;个人版受单进程限制,批量导入建议分批 |
| 存储增长 | 向量规模 ≈ 切块数 × 维度 × 4 字节;1536 维、2000 字符子块的中文语料大约每 1000 万字新增数十 MB 级向量 |
| 查询延迟 | 检索预算 30 秒 fail-open;embedding 服务慢会先表现为“引用变少”而非报错 |
常见问题:
- “知识库和项目的关系?” 知识库是文档集合;项目是工作组织(可绑定一个知识库、可开启自动加入上传)。对话可以附加多个知识库。
- “删除文档后向量会消失吗?” 会——删除文档会级联清理其切块与向量;在“文件”页删除则同时清除记录、索引与磁盘对象。
- “公开知识库谁能看到?” 库级
is_public只在工作空间语境内开放给成员,不是互联网公开;互联网可见的只有对话分享链接。
换模型、重建与备份
更换嵌入模型或迁移向量库的标准流程:
- 记录旧模型、旧维度与受影响知识库范围。
- 添加新 embedding 模型,用小样本文档验证维度与检索质量。
- 在后台完成模型切换(注意上方锁定规则与悬空恢复路径)。
- 在“系统 → 备份与迁移”的向量检查功能中先“检查向量”(统计:应有/正常/缺失/空向量/跳过),再对缺失部分“重建缺失向量”。
- 对旧内容与新上传内容分别做检索验收,全部索引完成前不下线旧模型。
备份必须同时覆盖关系数据、向量与原始文件:个人版重点是整个 DATA_DIR;完整版要把 PostgreSQL、Qdrant、Redis、沙盒归档卷和 DATA_DIR 当作一个一致性备份单元。完整备份 ZIP 已打包 Qdrant 向量,导入时会自动还原并在结果中报告向量还原状态。详细流程见升级、备份与恢复。