渠道、模型与策略
本文档基于 Aivory v2.4.7 编写。管理界面位于“AI 与模型”导航组下的“渠道 / 模型 / 模型标签 / 模型策略 / 上下文与记忆 / 内容审核”六个页签。
渠道保存“如何连接一个上游服务商”(协议类型 + Base URL + 凭据),模型保存“该连接可以调用哪个具体模型”(请求 ID + 能力 + 价格 + 策略)。二者分开管理,让同一个模型 ID 在不同账号、区域、网关或成本策略下共存。
用户能正常聊天的最小条件:存在一个已启用的可用渠道;至少一个关联该渠道的已启用聊天模型;模型策略中的“默认对话模型”有效。完整首次流程见管理员首次配置。
规划渠道
| 场景 | 建议 |
|---|---|
| 同一服务商有生产与测试 Key | 创建两条渠道,名称清楚标记环境;不要让测试 Key 支撑默认模型 |
| 同一模型通过两个网关可用 | 两条渠道 + 两条模型记录,便于独立排序、禁用或兜底 |
| 需要按团队、地区或成本分流 | 每个独立合同、区域或预算池一条渠道 |
| 服务商不提供模型列表接口 | 保留渠道后手动“新建模型”;列表导入不是使用渠道的前提 |
渠道 API Key 只应通过管理员后台保存(明文存于服务端数据库的渠道记录中,前端只回显掩码)。不要把服务商 Key 写进 VITE_*、前端页面、公开示例、浏览器请求参数或应用日志。
新建渠道:逐类型字段说明
新建对话框统一包含以下字段:
| 字段 | 说明 | 示例 | 默认 |
|---|---|---|---|
| 名称 | 管理员识别用,不影响请求 | OpenAI 生产 | 必填 |
| 类型 | 上游协议族:OpenAI / Claude / Gemini / Mock 等 | OpenAI | 必填 |
| 接口格式 | 仅对话模型使用,选择该渠道的对话协议变体 | chat / responses | 类型默认值 |
| Base URL | 上游 API 根地址,留空使用厂商默认端点 | https://api.openai.com/v1 | 厂商默认 |
| API Key | 服务端密钥;编辑时留空表示保留原密钥 | sk-… | 空 |
| 启用 | 禁用会使该渠道下所有模型立即不可用于新请求 | 开 | 开 |
- OpenAI 兼容
- Anthropic Claude
- Google Gemini
- Mock(联调)
- 类型选 OpenAI;几乎所有兼容网关(Azure 兼容端点、OneAPI 类网关、本地 Ollama/vLLM 的 OpenAI 端点)都走这一族。
- Base URL 填上游 API 根地址,可使用
/v1、/v2、/v3或网关自定义路径;留空即https://api.openai.com。填“网页控制台地址”而不是 API 地址是最常见错误。 - 接口格式:OpenAI 有 chat completions 与 responses 两套对话协议。以服务商文档为准;模型名相同不代表两套格式互通。
- 若希望 Aivory 同时从该渠道使用 embedding 或图片能力,只需在此渠道下创建对应类型的模型记录,渠道本身不需要切换。
- 类型选 Claude,签名与请求头按 Anthropic 协议处理。
- Base URL 留空即官方端点;经代理网关时填网关提供的兼容根地址。
- Claude 的模型能力(视觉、工具调用)以模型记录上的勾选为准,不要假设全系一致。
- 类型选 Gemini;Base URL 留空使用官方端点。
- 各代 Gemini 的函数调用与多模态支持差异较大,启用“深度研究”“视觉”等能力前先在测试对话验证。
- 不发出真实网络请求,返回可控的假响应,用于前端联调或演示。
- 环境变量
ENABLE_MOCK_PROVIDER=true可自动种入一条 mock 渠道;生产实例不要开启,也不要把 mock 模型指给默认策略。
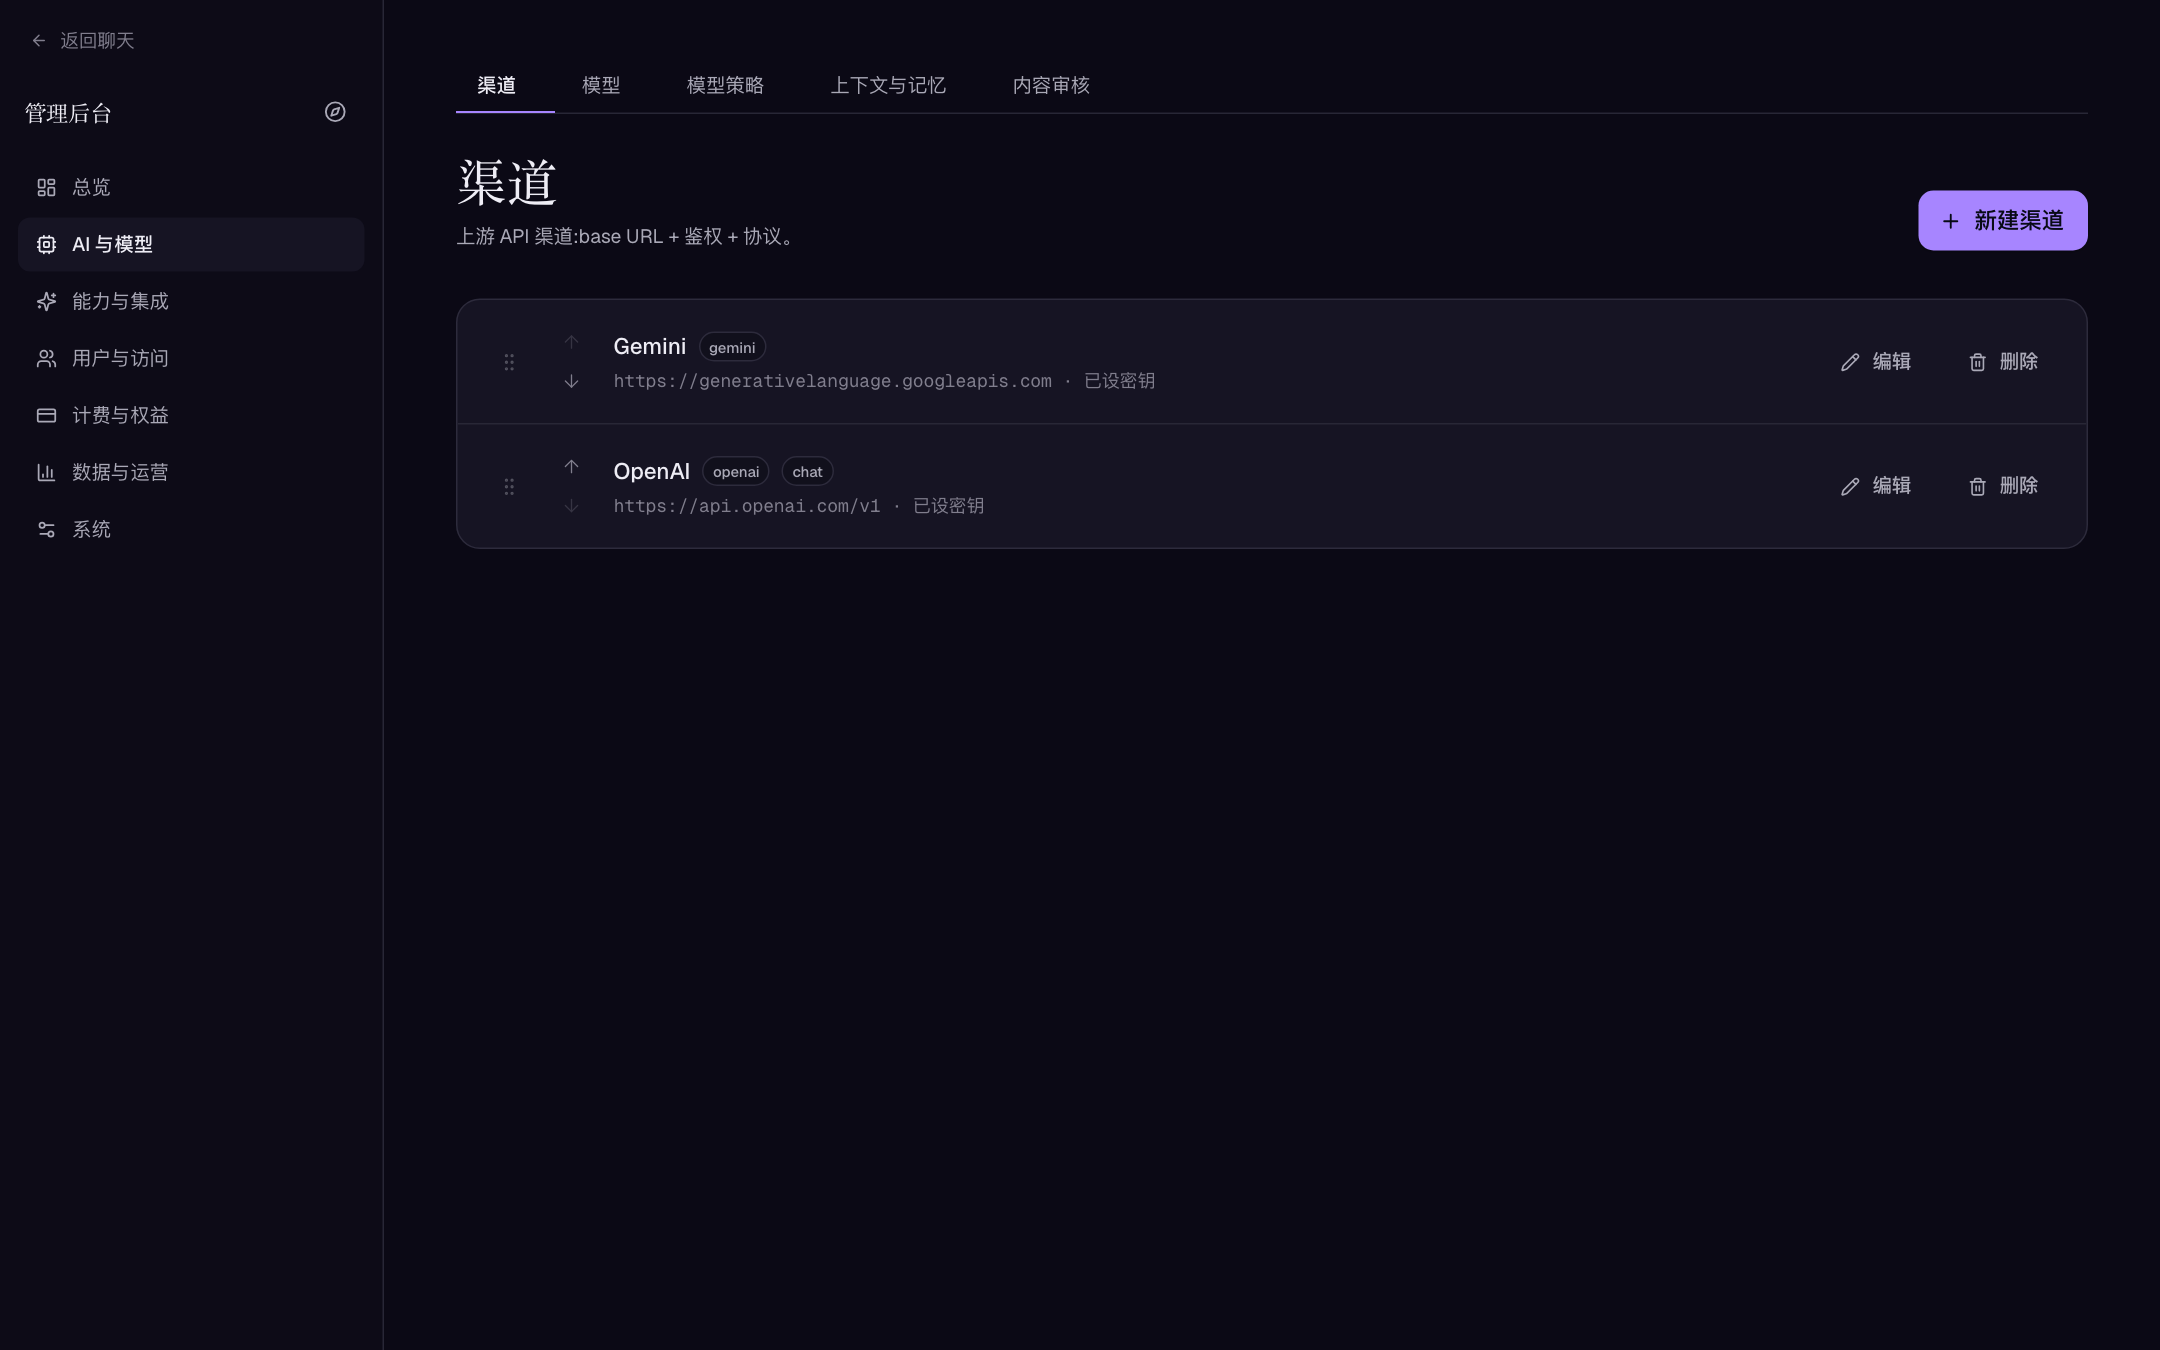
渠道列表与编辑对话框。列表中“已设密钥/未设置密钥”只表示状态,不回显 Key 内容。
保存后立即验证
- 保存并启用渠道。
- 在新建对话框中点“从上游获取”:能列出模型说明地址、密钥与网络三者都通。
- 无法列举不代表渠道不可用——很多服务商限制列表权限。直接添加一个已知模型 ID 并发一条真实短请求,验证网络、认证、模型授权与额度四件事。
模型发现与批量导入
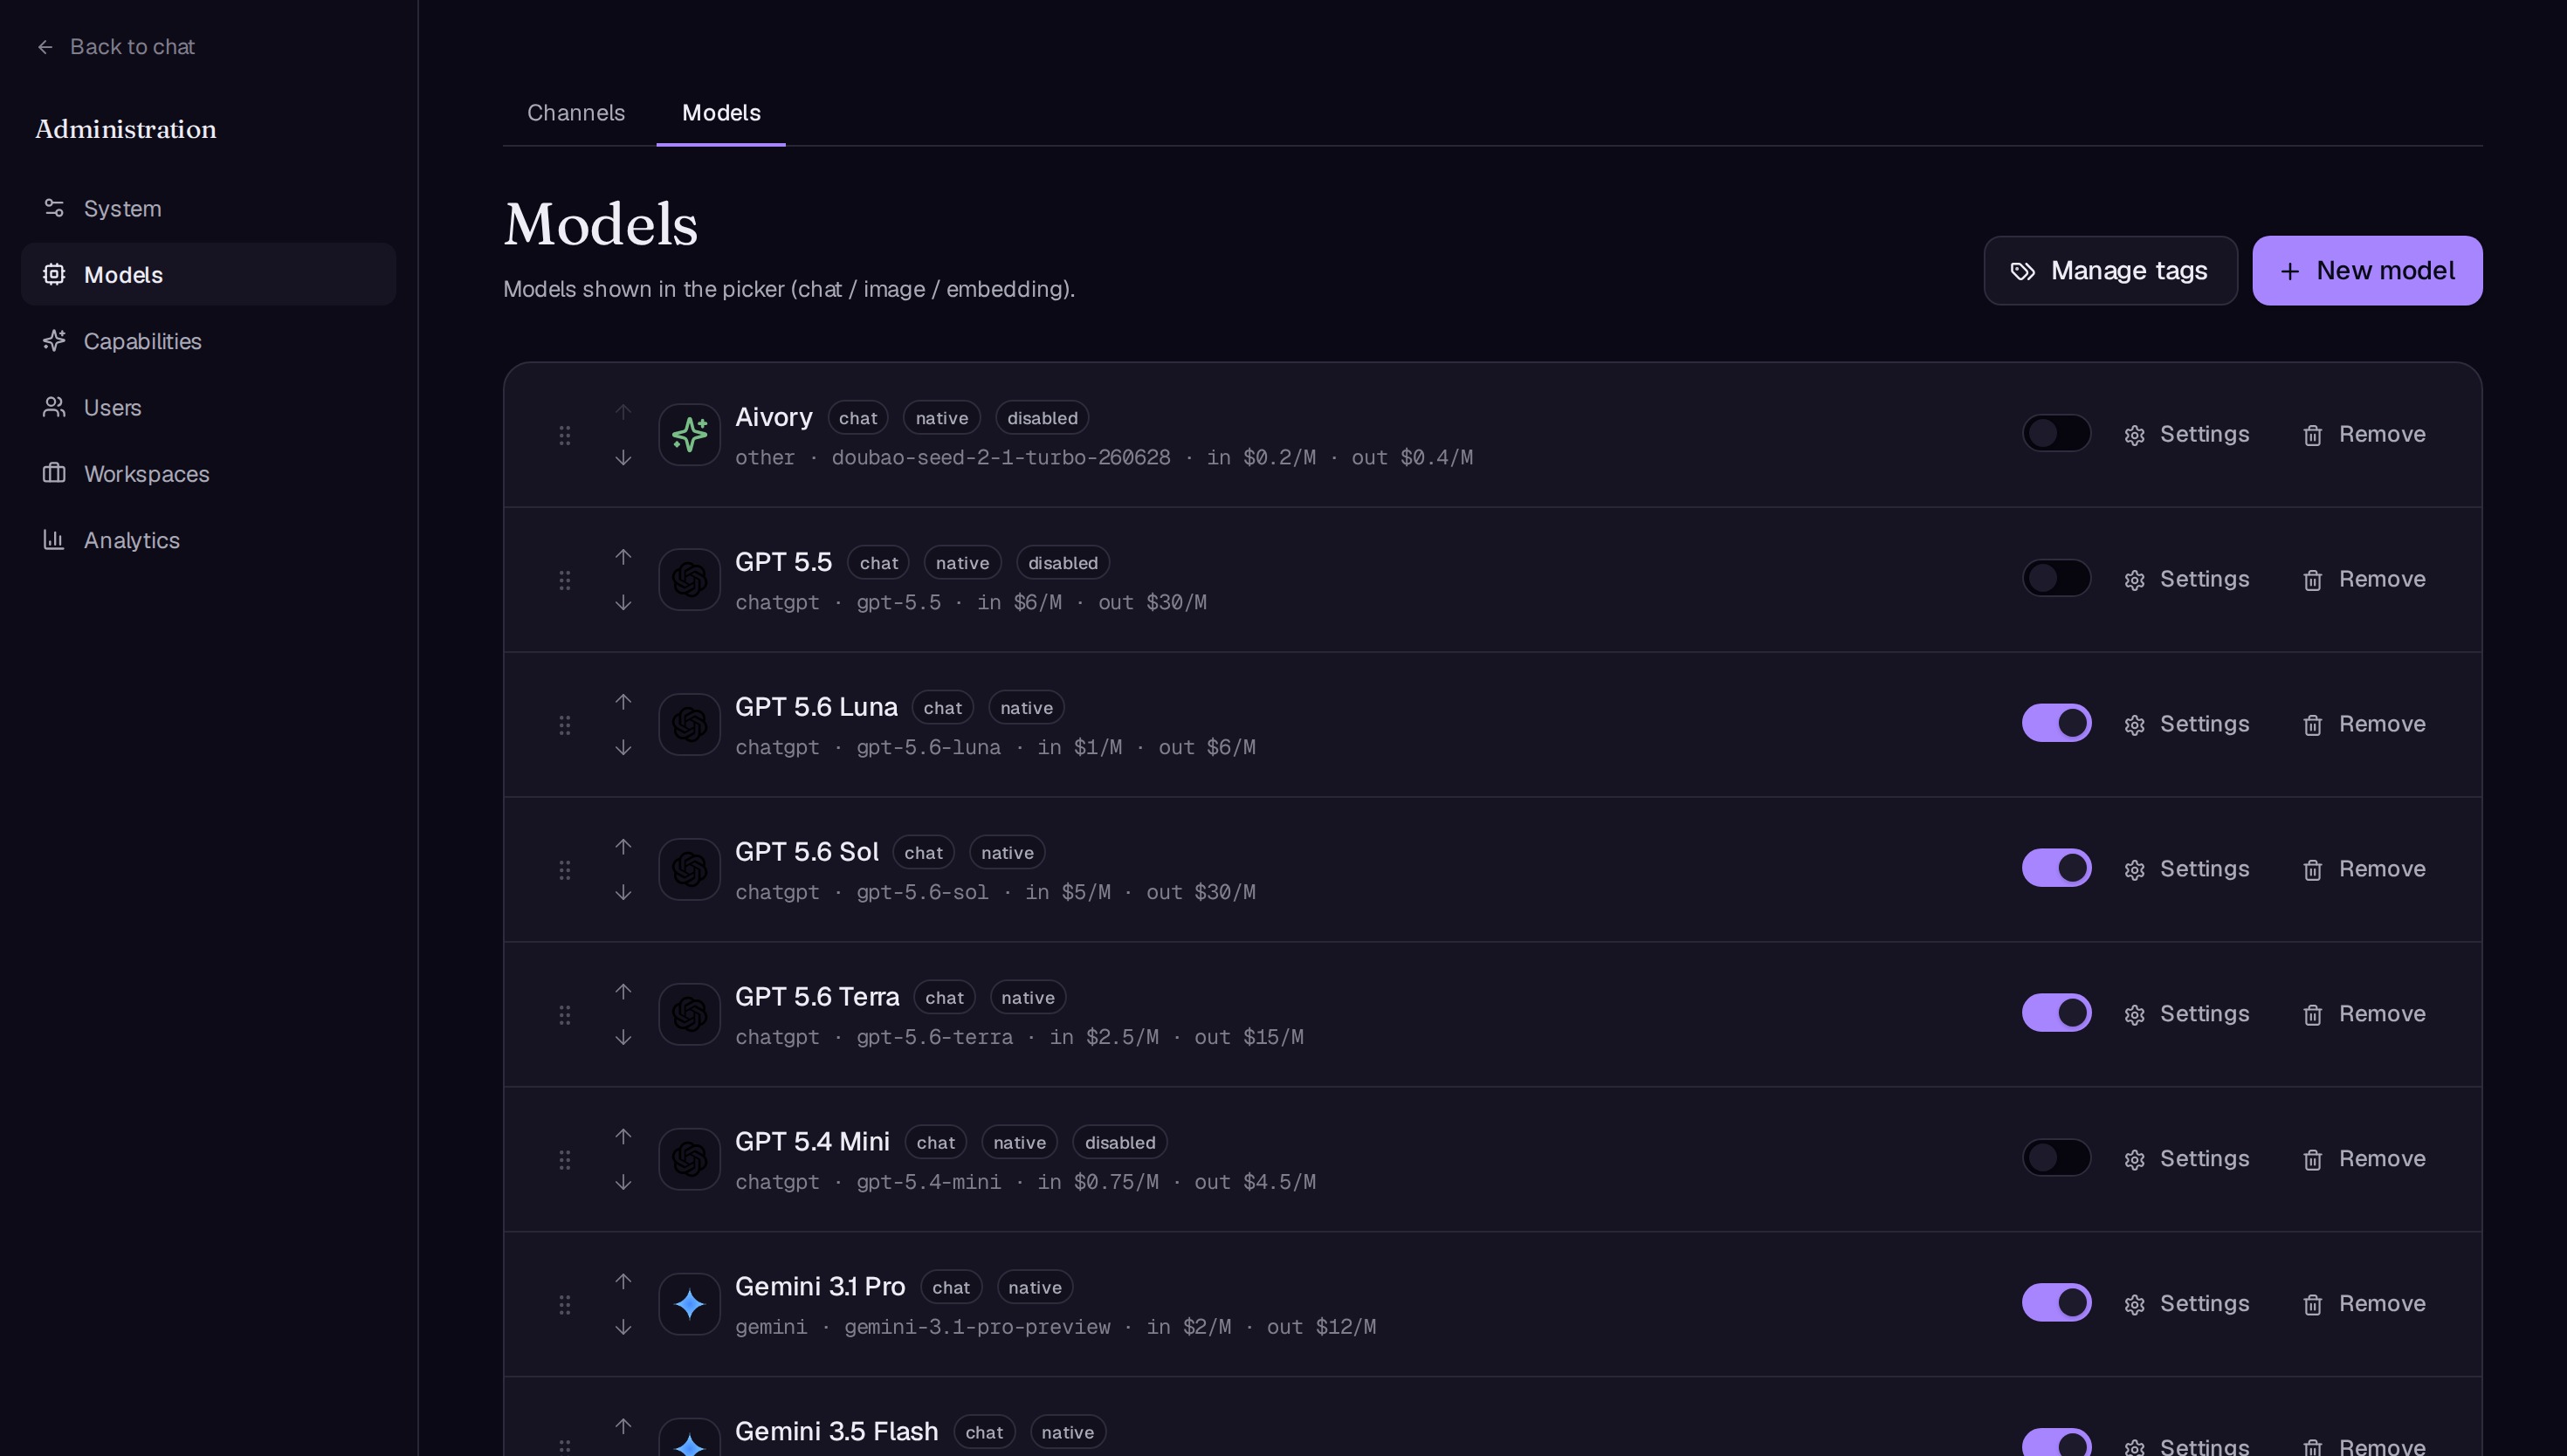
模型页提供两条路径:
- 拉取新模型(推荐日常增量):在“AI 与模型 → 模型”点击“拉取新模型”,选择一个已保存的渠道,Aivory 读取该渠道上游当前提供的模型列表;对话框会区分“可加入 / 已加入”,并自动隐藏 Aivory 暂不支持的条目。勾选后批量加入,重复的模型会被跳过并明确提示。
- 在渠道内“从上游获取”:新建/编辑渠道时直接勾选模型,适合首次接入。
- 手动新建模型:不开放列表接口、私有网关或仅允许推理的 Key 使用此路径。
自动导入不会替你决定:哪些模型对用户可见、是聊天/embedding/图片哪一种职责、价格与上下文描述是否正确。逐条检查启用状态、能力勾选和计费字段后再放开。
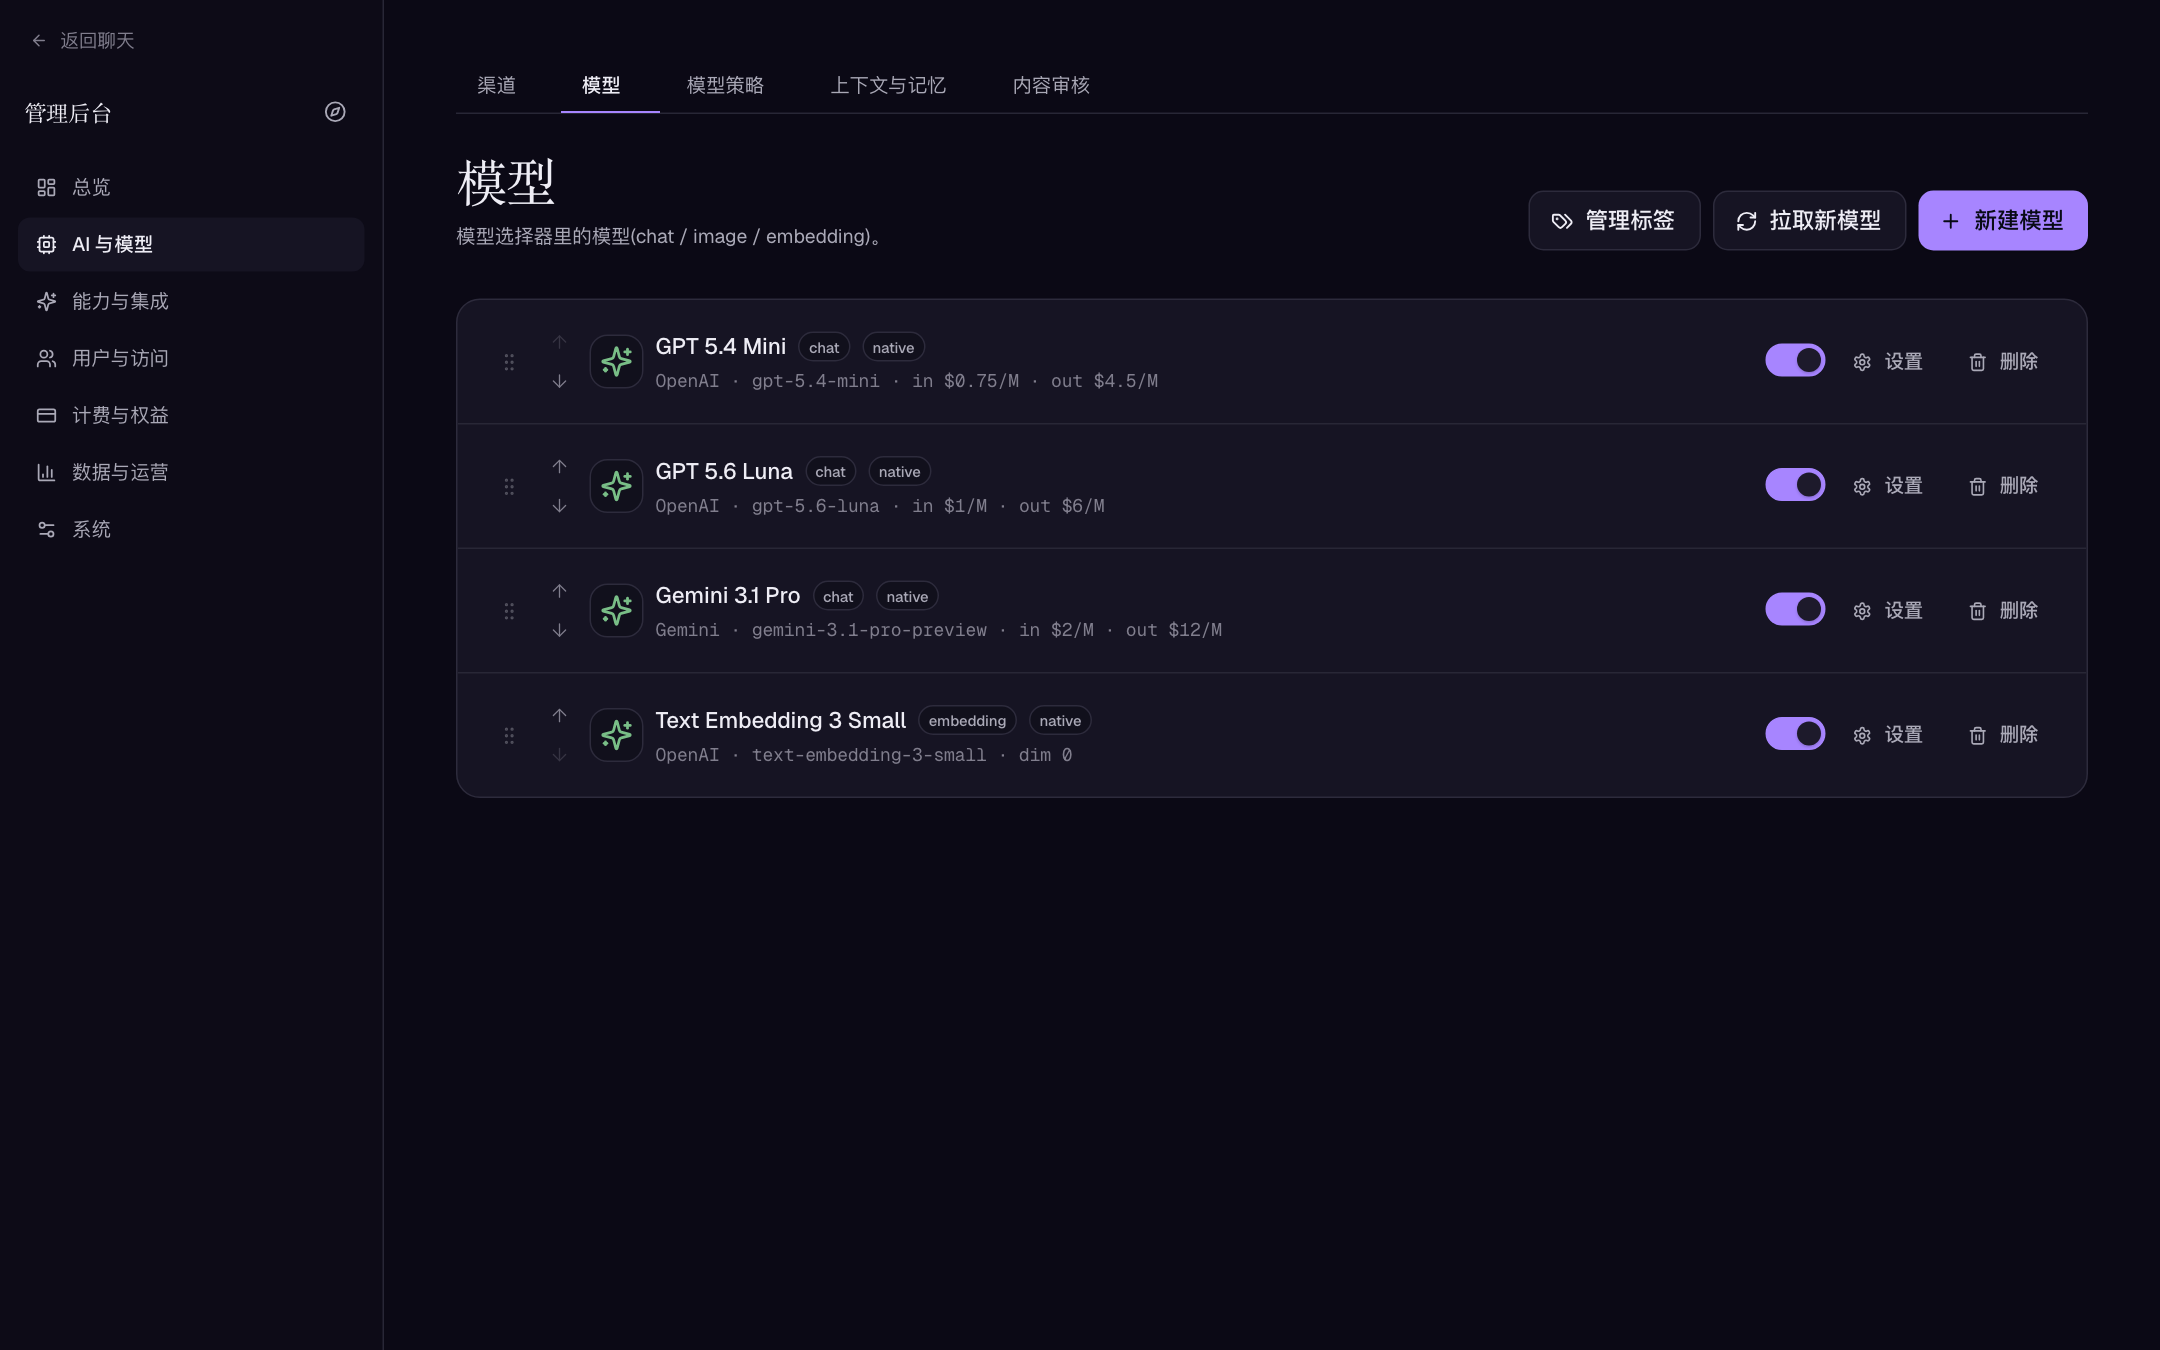
模型列表页。同一请求 ID 可以在不同渠道下各建一条记录,互不覆盖。
模型记录字段
编辑模型分“基本信息 / 对话行为 / 计费 / 权限 / 标签 / 技能 / 图片生成”几个区块,核心字段:
| 字段 | 说明 | 示例 | 默认 |
|---|---|---|---|
| 渠道 | 发起请求所用的上游 | OpenAI 生产 | 必填 |
| 兜底渠道 | 主渠道请求失败时在用户看到错误之前自动重试;类型与格式必须与主渠道一致,仅 URL 与密钥不同 | 备用网关 | 无 |
| 类型 | chat / image / embedding | chat | 必填 |
显示名 / request_id (实际请求 ID) | 前者给人看,后者是发给服务商的真实模型 ID | GPT 旗舰 / 真实 ID | 必填 |
| 工具模式 | 该模型使用工具的方式:native(原生函数调用)/ prompt(提示词模拟)/ none | native | 按类型 |
| 内置工具 | 此模型默认勾选的平台工具集合(“全部默认选中”或自定义) | 自定义 | 全部 |
| MCP 工具 | 此模型默认勾选的 MCP 服务;仅全局启用且已同步工具的服务可运行 | 自定义 | 默认关闭 |
| 服务商托管工具 | 默认不配置任何服务商侧工具;确有需要时逐条显式添加请求 JSON | — | 空 |
| 视觉 / 流式 / 深度研究 | 能力声明,影响上传入口与研究模式 | 开 | 按模型 |
| 快速模型 | 勾选后成为“快速”模式唯一模型:从进阶选择器隐藏、用户看不到其名称、强制关闭深度研究 | — | 否 |
| 系统提示词 | 附加到该模型每条请求的系统提示 | — | 空 |
| param_controls / 额外上游参数(JSON) | 用户可调参数映射与合并进上游请求的额外 JSON;优先级:内建参数 > 参数控件映射 > 额外参数 | {"temperature":0.7} | 空 |
| 向量维度 | embedding 模型必填,必须与模型真实输出一致 | 1536 | — |
| 压缩阈值(token) | 覆盖全局上下文压缩触发值;0 = 使用全局阈值 | — | 0 |
| 输入/输出/缓存读/缓存写价格、单张图片价格 | 用于积分扣减与“用量与计费”统计的每 1M token 单价 | 按服务商 | 0 |
| 启用(对用户可见) | 关闭后不出现在选择器与新请求中 | — | 开 |
“模型能在选择器里出现,但第一条请求就失败”几乎都是能力标记与上游实际不符:把不支持函数调用的模型标成 native 工具模式、把聊天模型标成 embedding、或假设所有模型都支持视觉/JSON/流式。逐能力做一条最小测试请求。
模型策略与上下文压缩
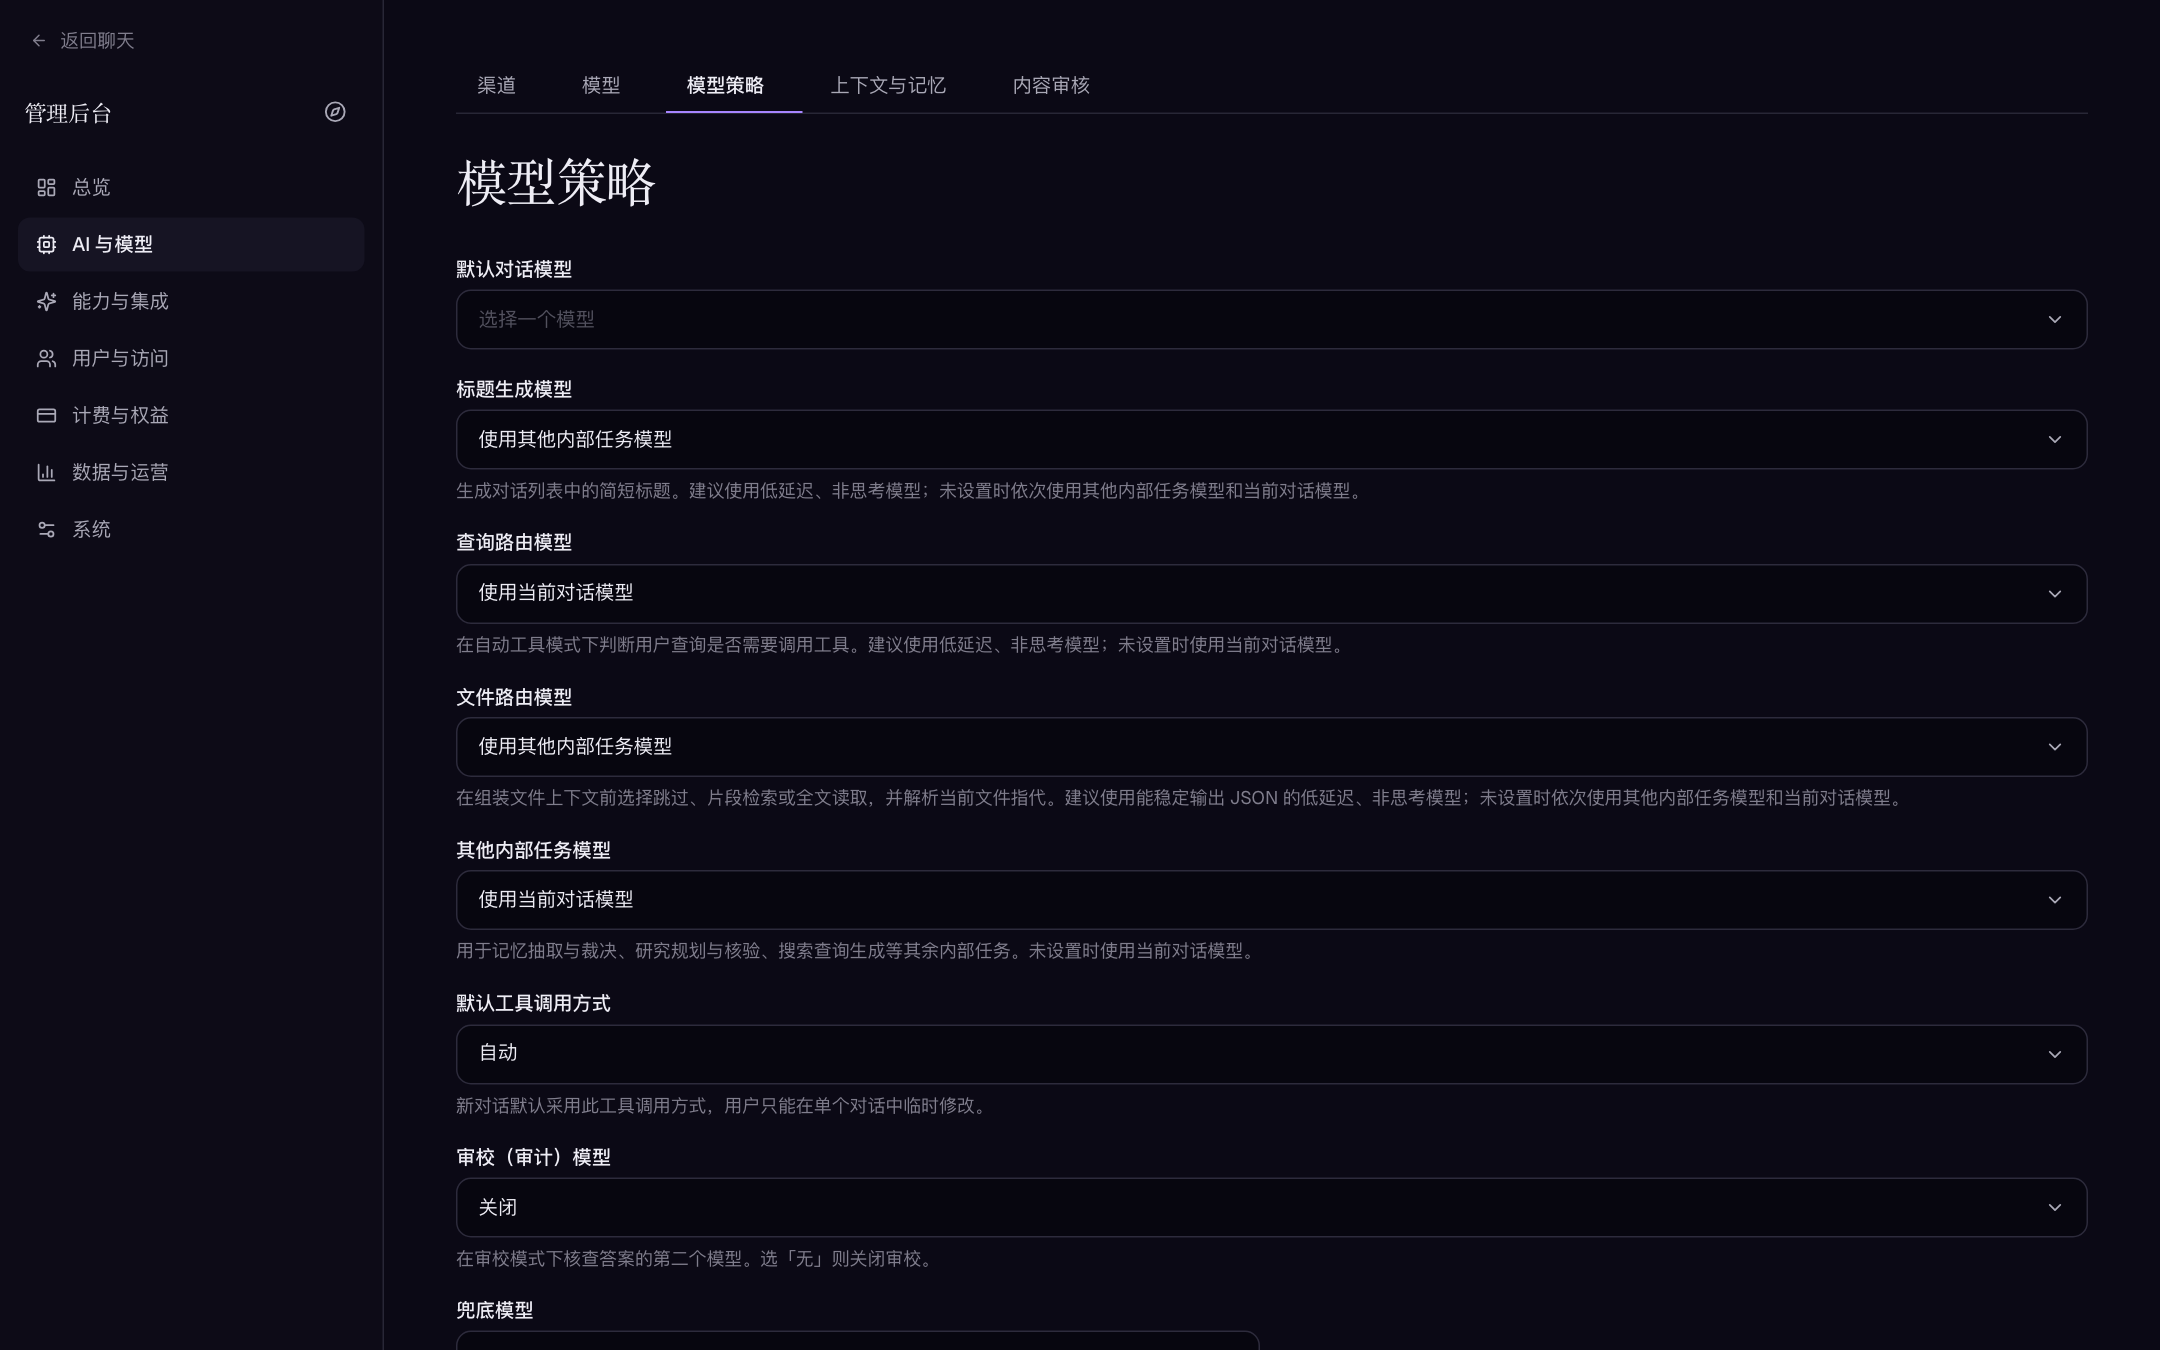
“AI 与模型 → 模型策略”维护系统级模型选择。留空的槽位按提示回退到当前对话模型或任务模型,默认对话模型是唯一硬性项:
| 字段 | 用途 | 建议 |
|---|---|---|
| 默认对话模型 | 新对话使用的主模型 | 已验证、成本可控的聊天模型 |
| 标题生成模型 | 生成对话列表标题 | 低延迟、非思考模型 |
| 查询路由模型 | 自动工具模式下判断查询是否需要调用工具 | 低延迟、非思考模型 |
| 文件路由模型 | 组装文件上下文前决定跳过/片段检索/全文读取 | 能稳定输出 JSON 的模型 |
| 其他内部任务模型 | 记忆抽取、研究规划与核验、搜索查询生成等 | 稳定通用的中档模型 |
| 审校(审计)模型 | 审校模式下核查答案的第二个模型 | 选“无”即关闭审校 |
| 图片提示词模型 | 绘图前润色提示词 | 选“无”则跳过 |
| 默认工具调用方式 | 新对话默认的工具模式(自动/开启/关闭) | 自动 |
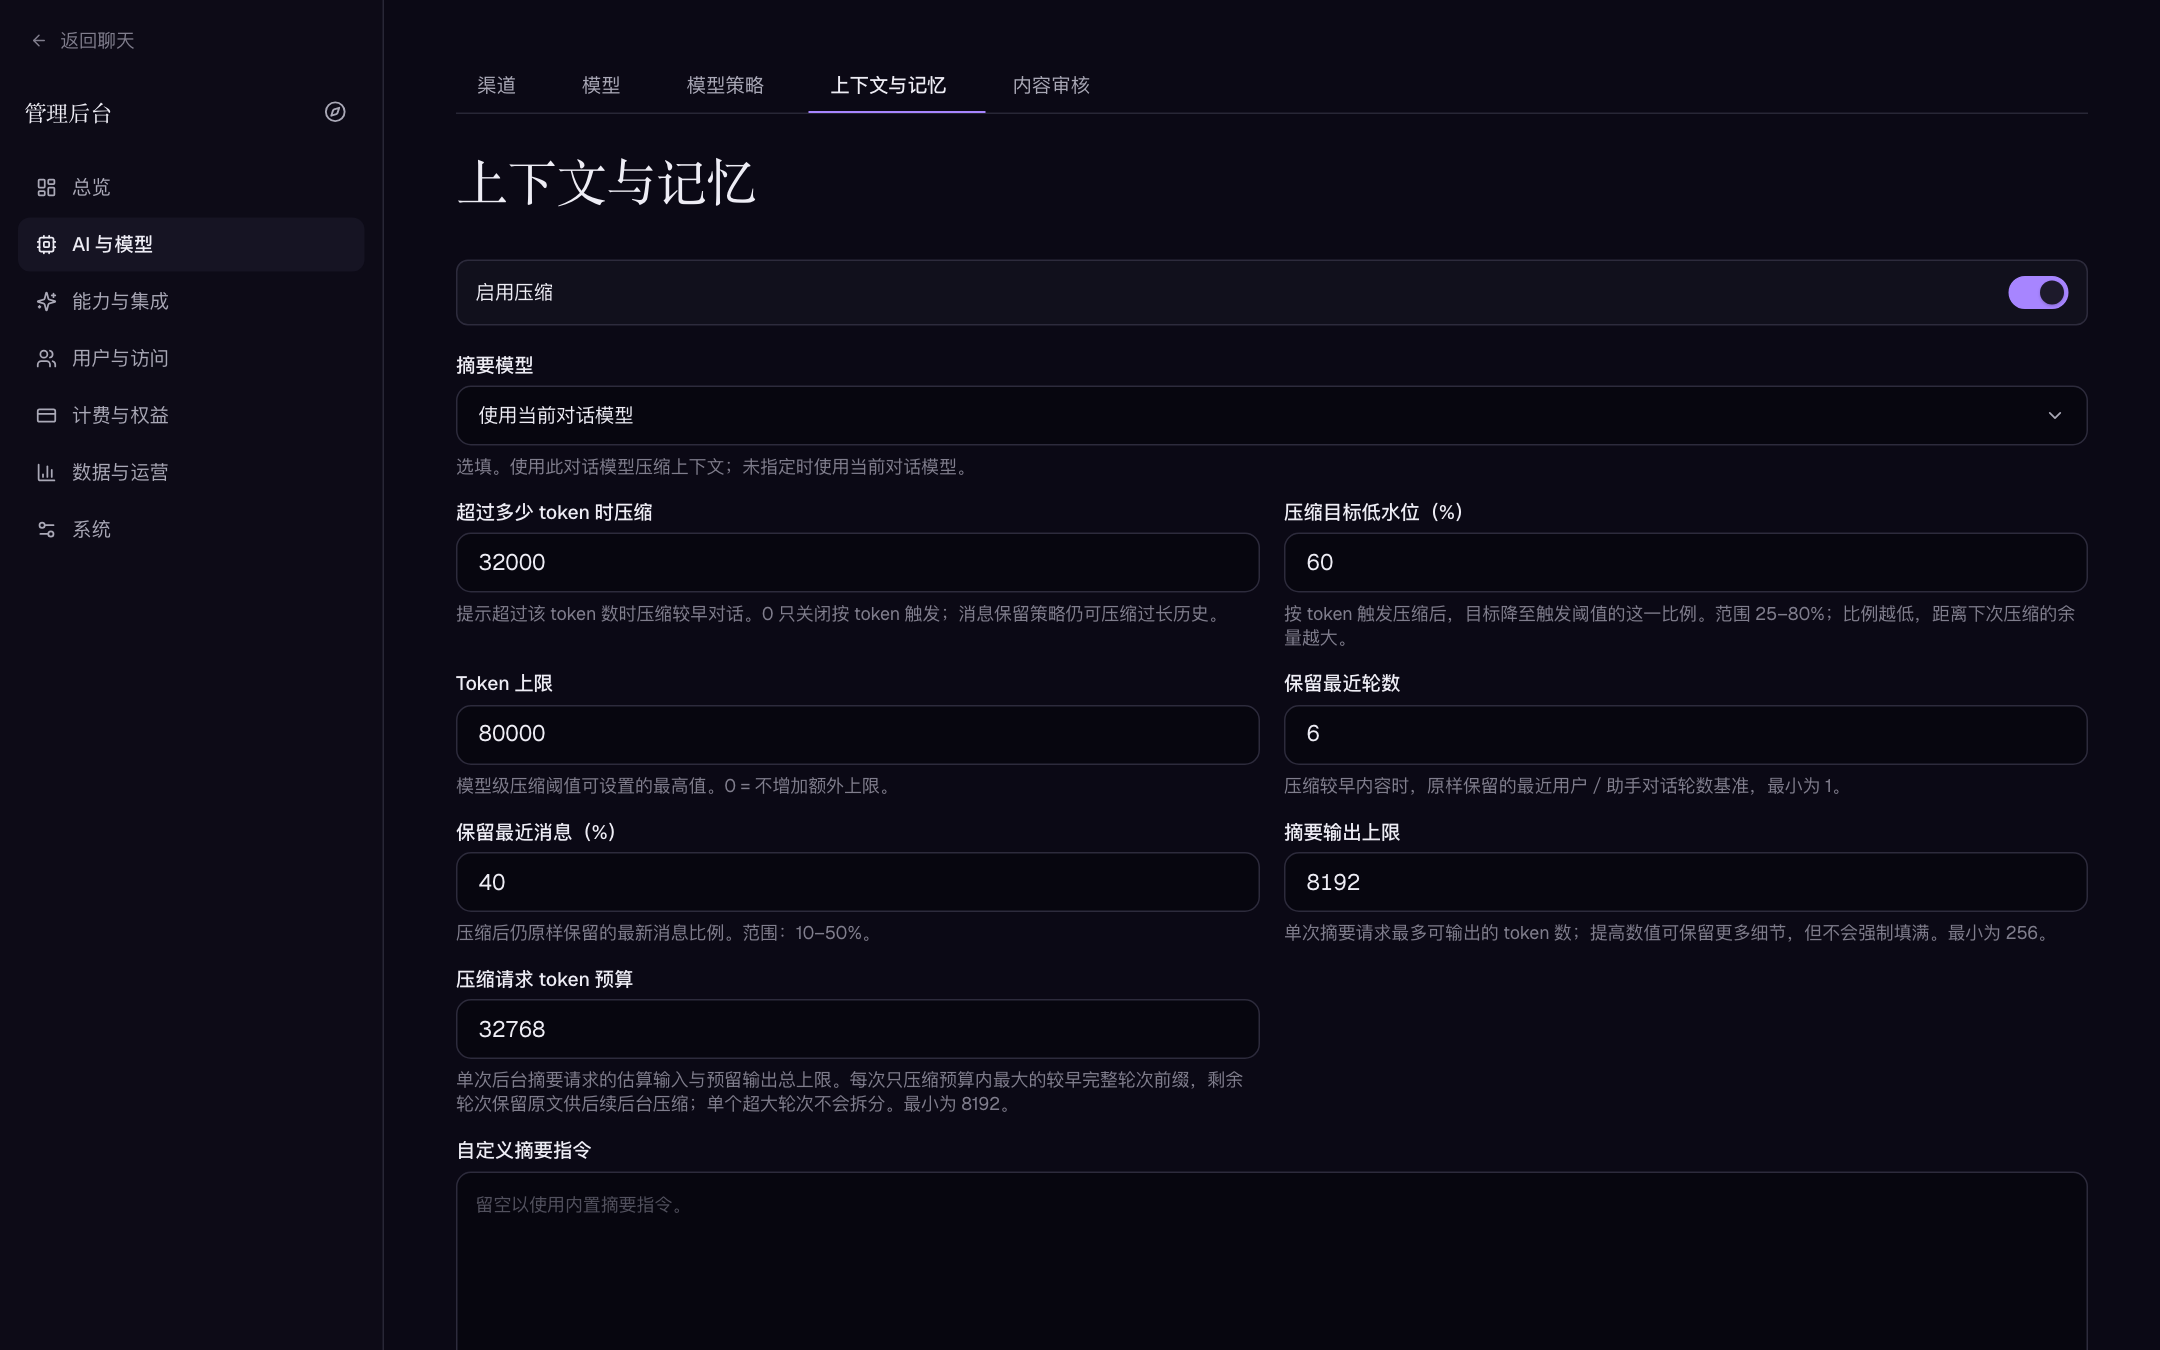
“AI 与模型 → 上下文与记忆”控制长对话的压缩与记忆行为,关键项与默认值:
| 字段 | 说明 | 默认 |
|---|---|---|
| 启用压缩 / 启用记忆 | 总开关 | 开 / 开 |
| 保留最近轮数 | 压缩时原样保留的最近对话轮数基准 | 6 |
| 超过多少 token 时压缩 | 触发压缩的估算提示 token 数 | 32000 |
| 压缩目标低水位(%) | 压缩后目标降至触发阈值的比例(25–80) | — |
| 保留最近消息(%) | 压缩后仍原样保留的最新消息比例(10–50) | — |
| 摘要输出上限 | 单次摘要请求最大输出 token | 8192 |
| 压缩请求 token 预算 | 单次后台摘要请求输入+预留输出总上限 | — |
| 摘要模型 | 留空使用当前对话模型 | 空 |
排序、标签、可见性与配额
- 模型标签(“AI 与模型 → 模型标签”)用于选择器筛选,适合把“推荐 / 经济 / 长上下文 / 图像”等运营语义显式化。
- 模型的可见性与额度通过用户组与模型页“权限”区块控制:模型组配额(按费用或次数、按周期滚动)决定哪些组可用、超出后扣积分还是拒绝。详见套餐、积分与支付。
- 建议默认只给用户少量已验证模型,再按成本、上下文、速度或数据处理边界逐步放开。
变更与故障处理
安全的渠道/模型变更流程:
- 记录当前默认模型、各策略槽位、引用该模型的套餐、工作区策略与配额。
- 创建或修改渠道,保存新凭据。
- 用目标模型发短请求,检查流式、工具、图片或 embedding 等实际能力。
- 再修改启用状态、排序和全局策略。
- 观察“用量”与错误记录、用户反馈,确认稳定后才停用旧渠道/旧模型。轮换密钥时先验证新 Key,再停用旧凭据,避免直接删除导致用户对话中断。
常见测试连接失败
| 症状 | 优先检查 |
|---|---|
| 401 / 认证失败 | API Key 是否复制完整、是否已吊销;编辑渠道时留空 Key 表示保留旧值,不是清除 |
| 404 / 模型不存在 | request_id 与服务商文档是否逐字符一致;接口格式是否选对(chat vs responses) |
| Base URL 报错 | 是否填了控制台网页地址;OpenAI 类型是否包含网关要求的版本路径 |
| 列表拉取失败 | 服务商是否允许列举模型、服务器出网与 DNS、Key 是否只允许推理 |
| 请求超时/断流 | 到上游的网络路径、代理超时;反向代理是否缓冲了 SSE 流(见域名、HTTPS 与 OAuth) |
| 有模型但无法聊天 | 模型类型、启用状态、所属渠道启用状态、默认策略是否指向它 |
| 同 ID 选错上游 | 模型记录关联的渠道,而不是显示名 |
| 兜底渠道未生效 | 兜底渠道类型与接口格式必须与主渠道一致,否则不会自动重试 |
禁用渠道会立即使其下所有模型不可用于新请求;删除渠道会级联删除其下模型记录。禁用/删除模型前,先确认它没有被默认策略、审校、图片提示词、摘要、工作区策略、套餐配额或用户收藏引用。